맥북 한 대로 AI 개발팀 굴리기 (2) — 사용량 관리와 모델 배치
시리즈: 멀티 에이전트 하네스 구축기
1편: 설계와 작업 흐름
2편: 사용량 관리와 모델 배치 (이 글)
3편: Agent Office와 삽질 모음
1편에서 M4 맥북 위에 OpenCode + oh-my-openagent(OmO)로 하네스의 뼈대를 세웠다. 이번 편은 그 하네스에서 가장 많이 갈아엎은 부분, 사용량 관리다.
에이전트 여럿이 동시에 돌면 토큰이 생각보다 훨씬 빨리 녹는다. 구독형 Codex는 5시간·주간 한도가 있고, 무료 모델은 분당·하루 요청 수 제한이 있다. "한도가 차면 알아서 다른 모델로 넘긴다"는 한 줄짜리 요구사항이 실제로는 다섯 번을 고쳐서야 자리를 잡았다.
1. 사용량 관리 변천사
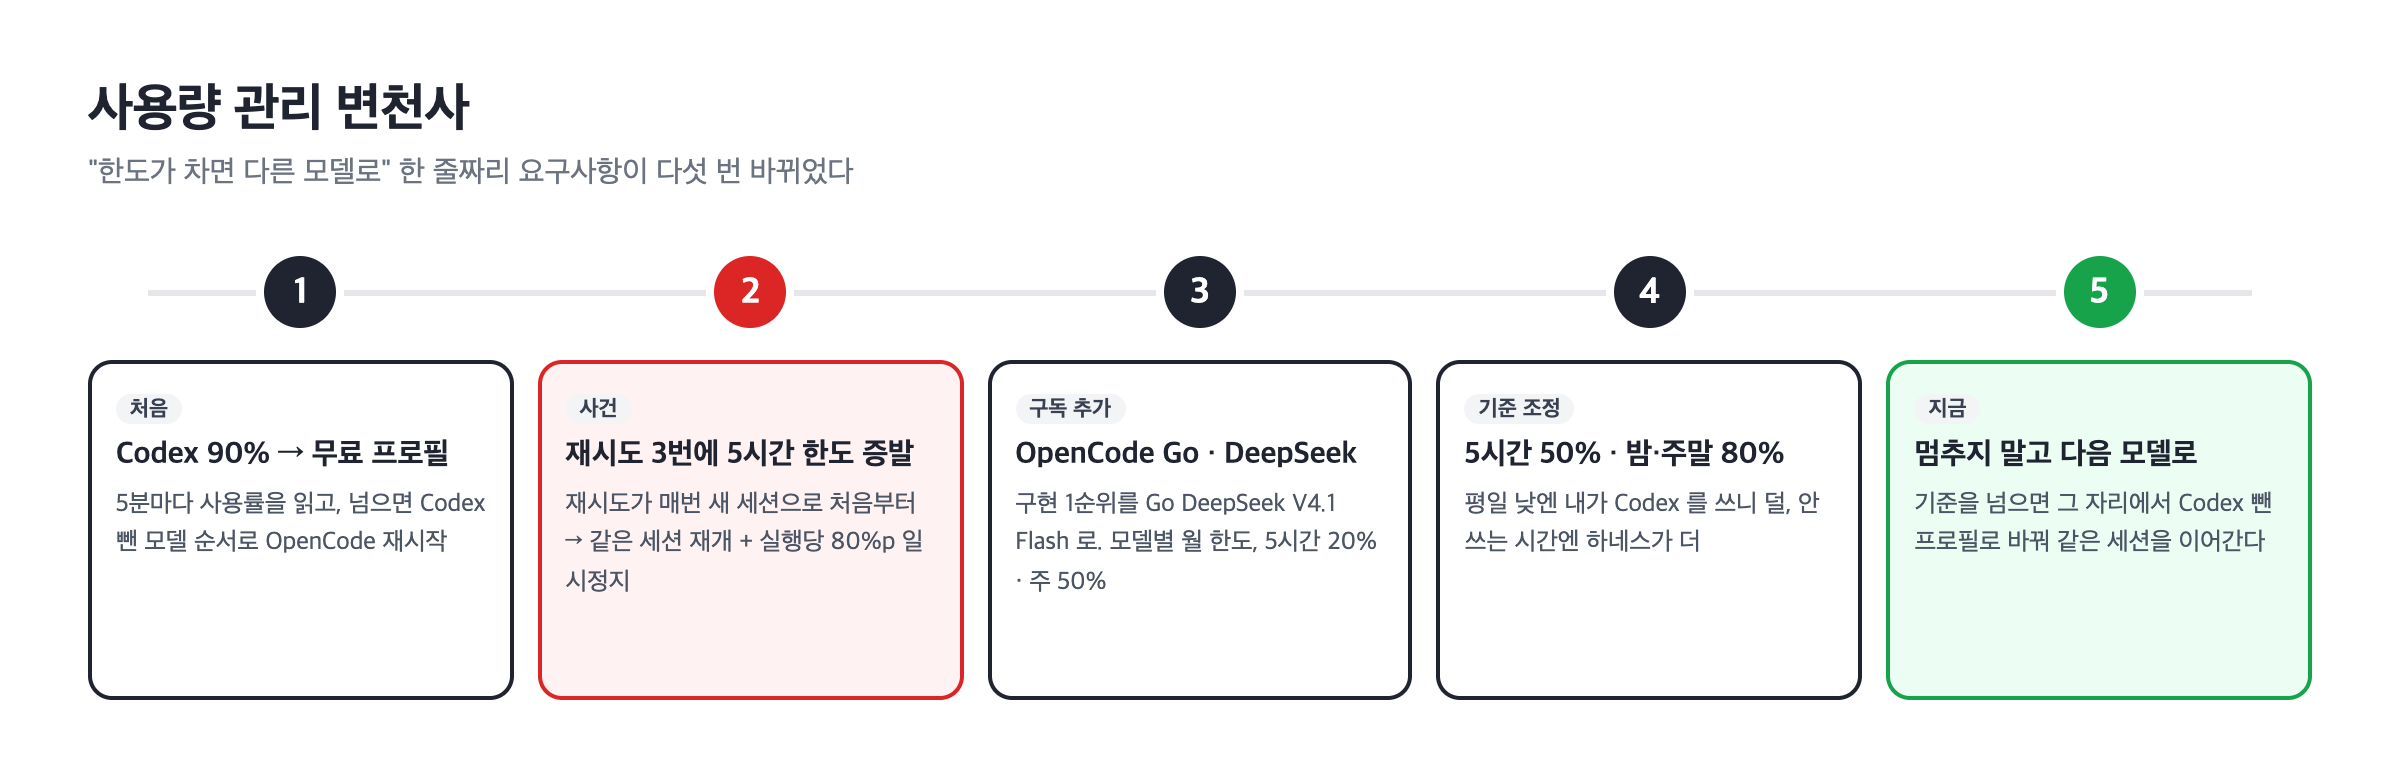
① 처음: Codex 90%에서 무료 모델로 전환
usage_watch.py가 Codex 사용량(5시간·주간 창)을 5분마다 읽는다. 90%를 넘으면 codex_ok=false가 된다. 그러면 launchd가 OpenCode를 무료 프로필로 다시 띄운다. 무료 프로필은 OmO 모델 순서에서 Codex를 뺀 것이다.
② 사건: 재시도 세 번에 5시간 한도가 증발했다
한도 소진 직후 재시도가 세 번 돌았는데, 그때마다 새 세션이 처음부터 다시 시작했다. 거대한 컨텍스트를 매번 새로 밀어 넣느라 5시간 한도가 순식간에 사라졌다. 작업 자체는 그만큼 토큰을 쓸 일이 아니었는데도 그랬다. 그래서 두 가지를 넣었다.
- 한도에 걸리면 같은 세션에서 멈춘 지점부터 재개한다. 처음부터 다시 하지 않는다.
- 한 번 실행이 5시간 한도를 80%p 넘게 쓰면 일시정지하고, 텔레그램으로 계속할지 묻는다.
③ OpenCode Go 구독과 DeepSeek
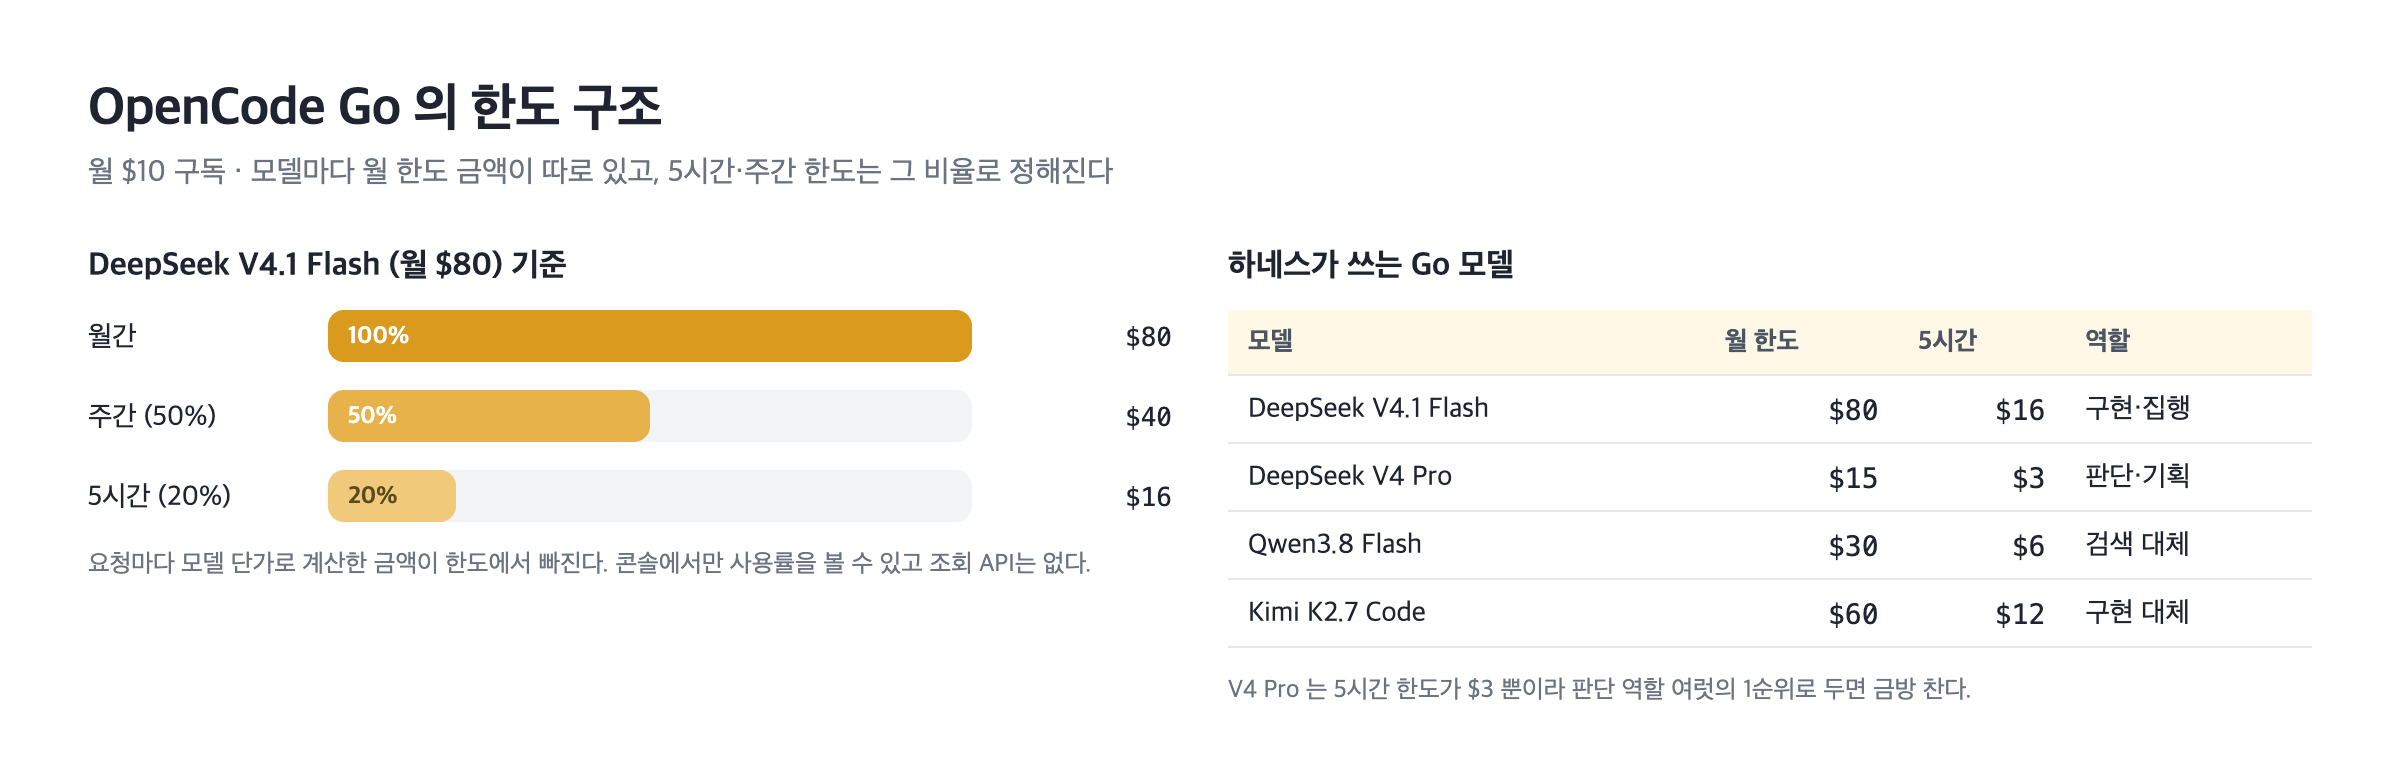
Codex 한도가 자주 바닥나서 OpenCode Go(월 $10)를 구독했다. DeepSeek V4.1 Flash를 구현 담당의 1순위로 올렸다.
Go의 한도 구조는 이렇다.
- 모델마다 월 한도 금액이 따로 있다. 예를 들어 DeepSeek V4.1 Flash는 $80, V4 Pro는 $15다.
- 5시간 한도는 그 20%, 주간 한도는 50%다.
DeepSeek 모델은 데이터를 저장하지 않는다(ZDR, 매달 갱신). 이게 나중에 개인 데이터 레포에도 쓸 수 있는 근거가 됐다.
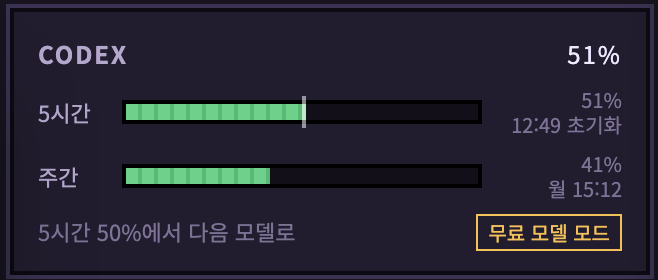
④ 기준을 5시간 50%로, 밤과 주말은 80%로
평일 낮에는 내가 직접 Codex를 써야 하니 하네스는 5시간 한도의 50%까지만 쓴다. 대신 평일 19시~새벽 4시와 토·일요일은 80% 까지 쓴다. 내가 안 쓰는 시간에는 하네스가 더 쓰는 식이다.
| 시간대 | 하네스가 쓰는 Codex 5시간 한도 |
| 평일 04:00~19:00 | 50% |
| 평일 19:00~다음 날 04:00 | 80% |
| 토·일요일 종일 | 80% |
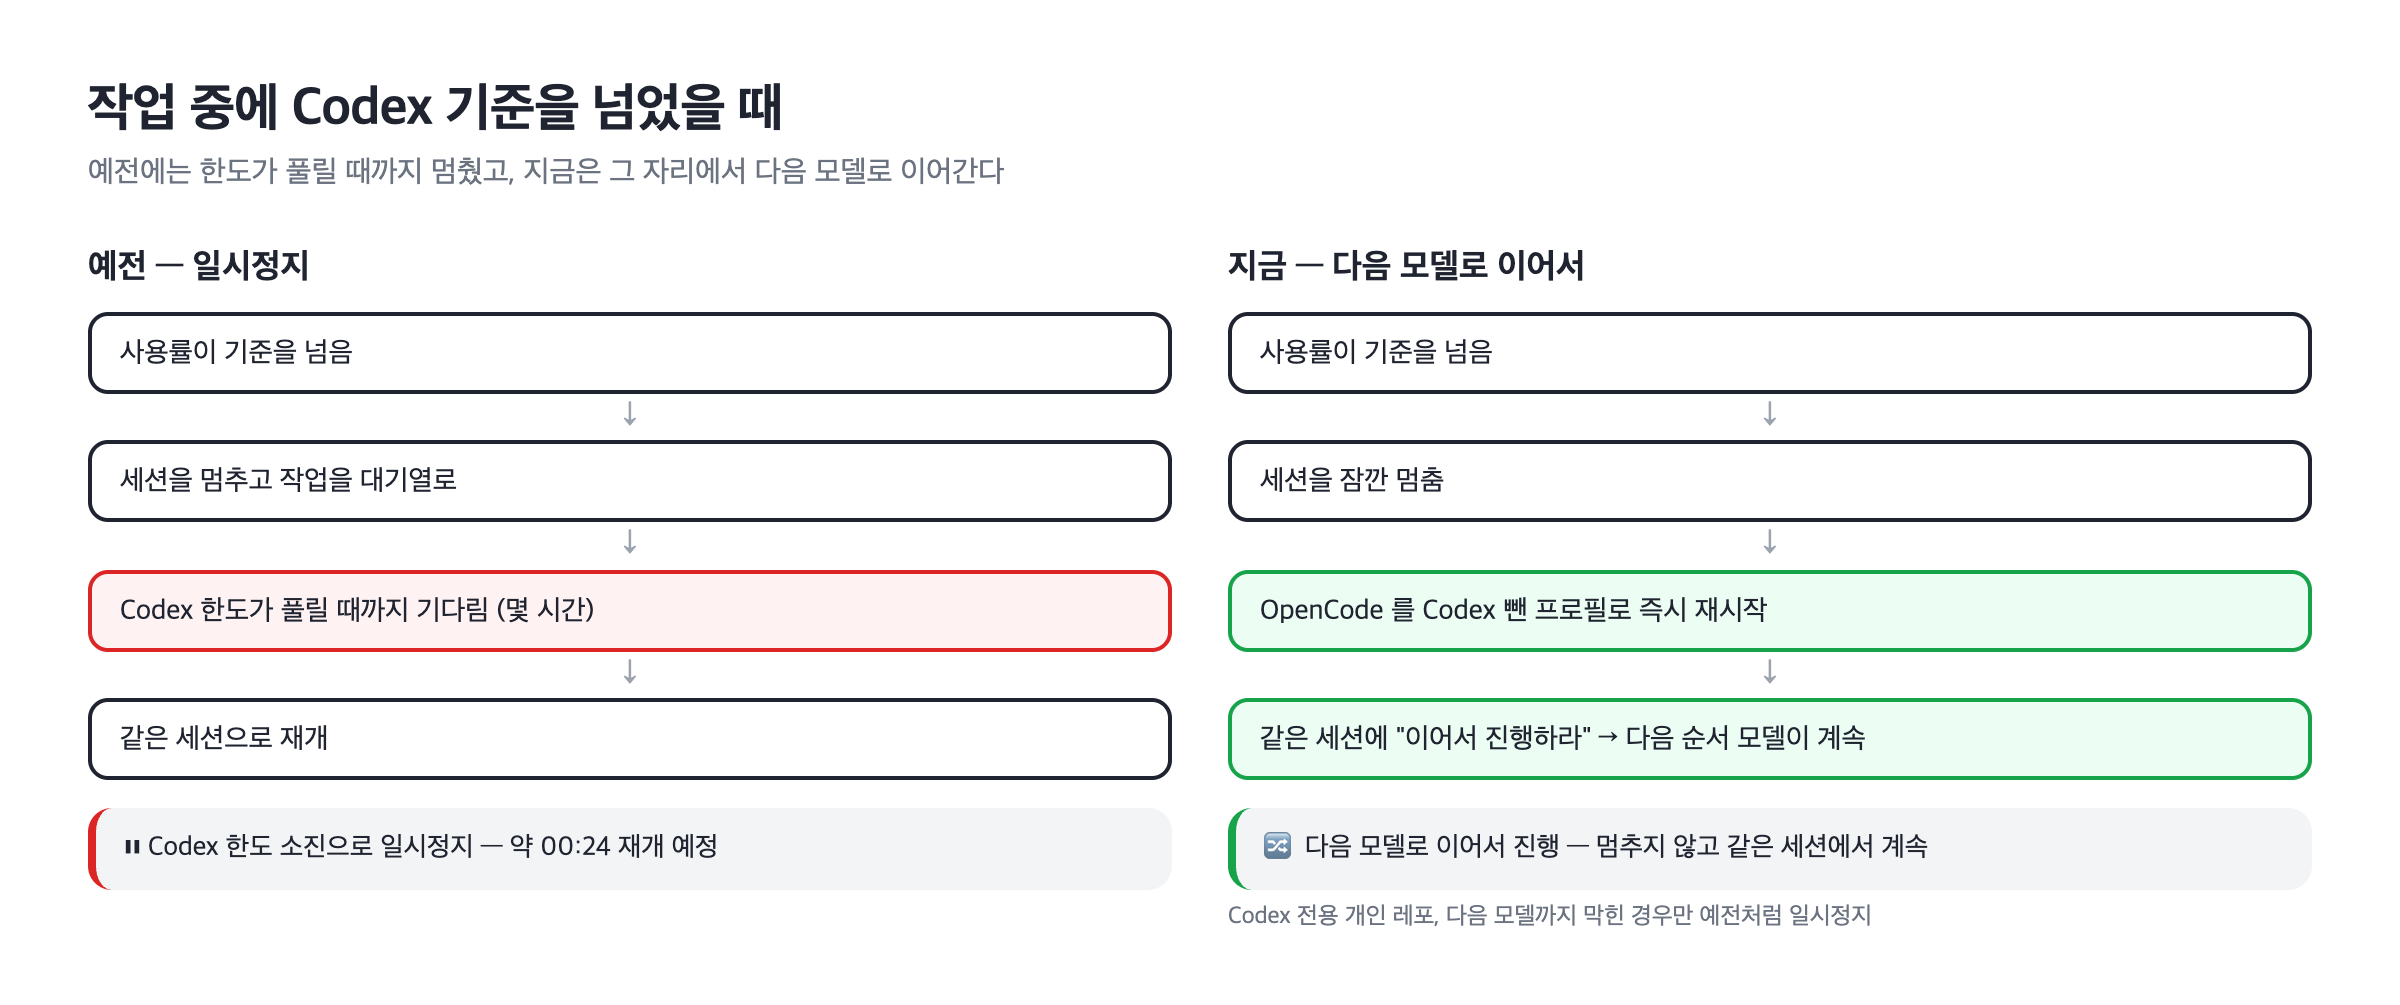
⑤ 마지막: 기준을 넘으면 멈추지 말고 다음 모델로
처음 만든 "한도 → 일시정지 → 한도 풀리면 재개" 장치가 남아 있었다. 그래서 기준을 넘으면 작업이 몇 시간씩 멈췄다. "한도가 차면 다음 모델이 이어서 하면 되는 거 아냐?" 맞는 말이다. 지금은 작업 중에 기준을 넘으면 세 단계로 바로 넘어간다.
- 세션을 잠깐 멈춘다.
- OpenCode를 Codex 뺀 프로필로 즉시 다시 띄운다.
- 같은 세션에 "이어서 진행하라"를 보낸다.
텔레그램에는 ⏸ 대신 🔀 다음 모델로 이어서 진행이 온다. 일시정지는 Codex 전용 개인 레포와, 다음 모델까지 막혔을 때만 남겼다.
2. 지금의 모델 배치
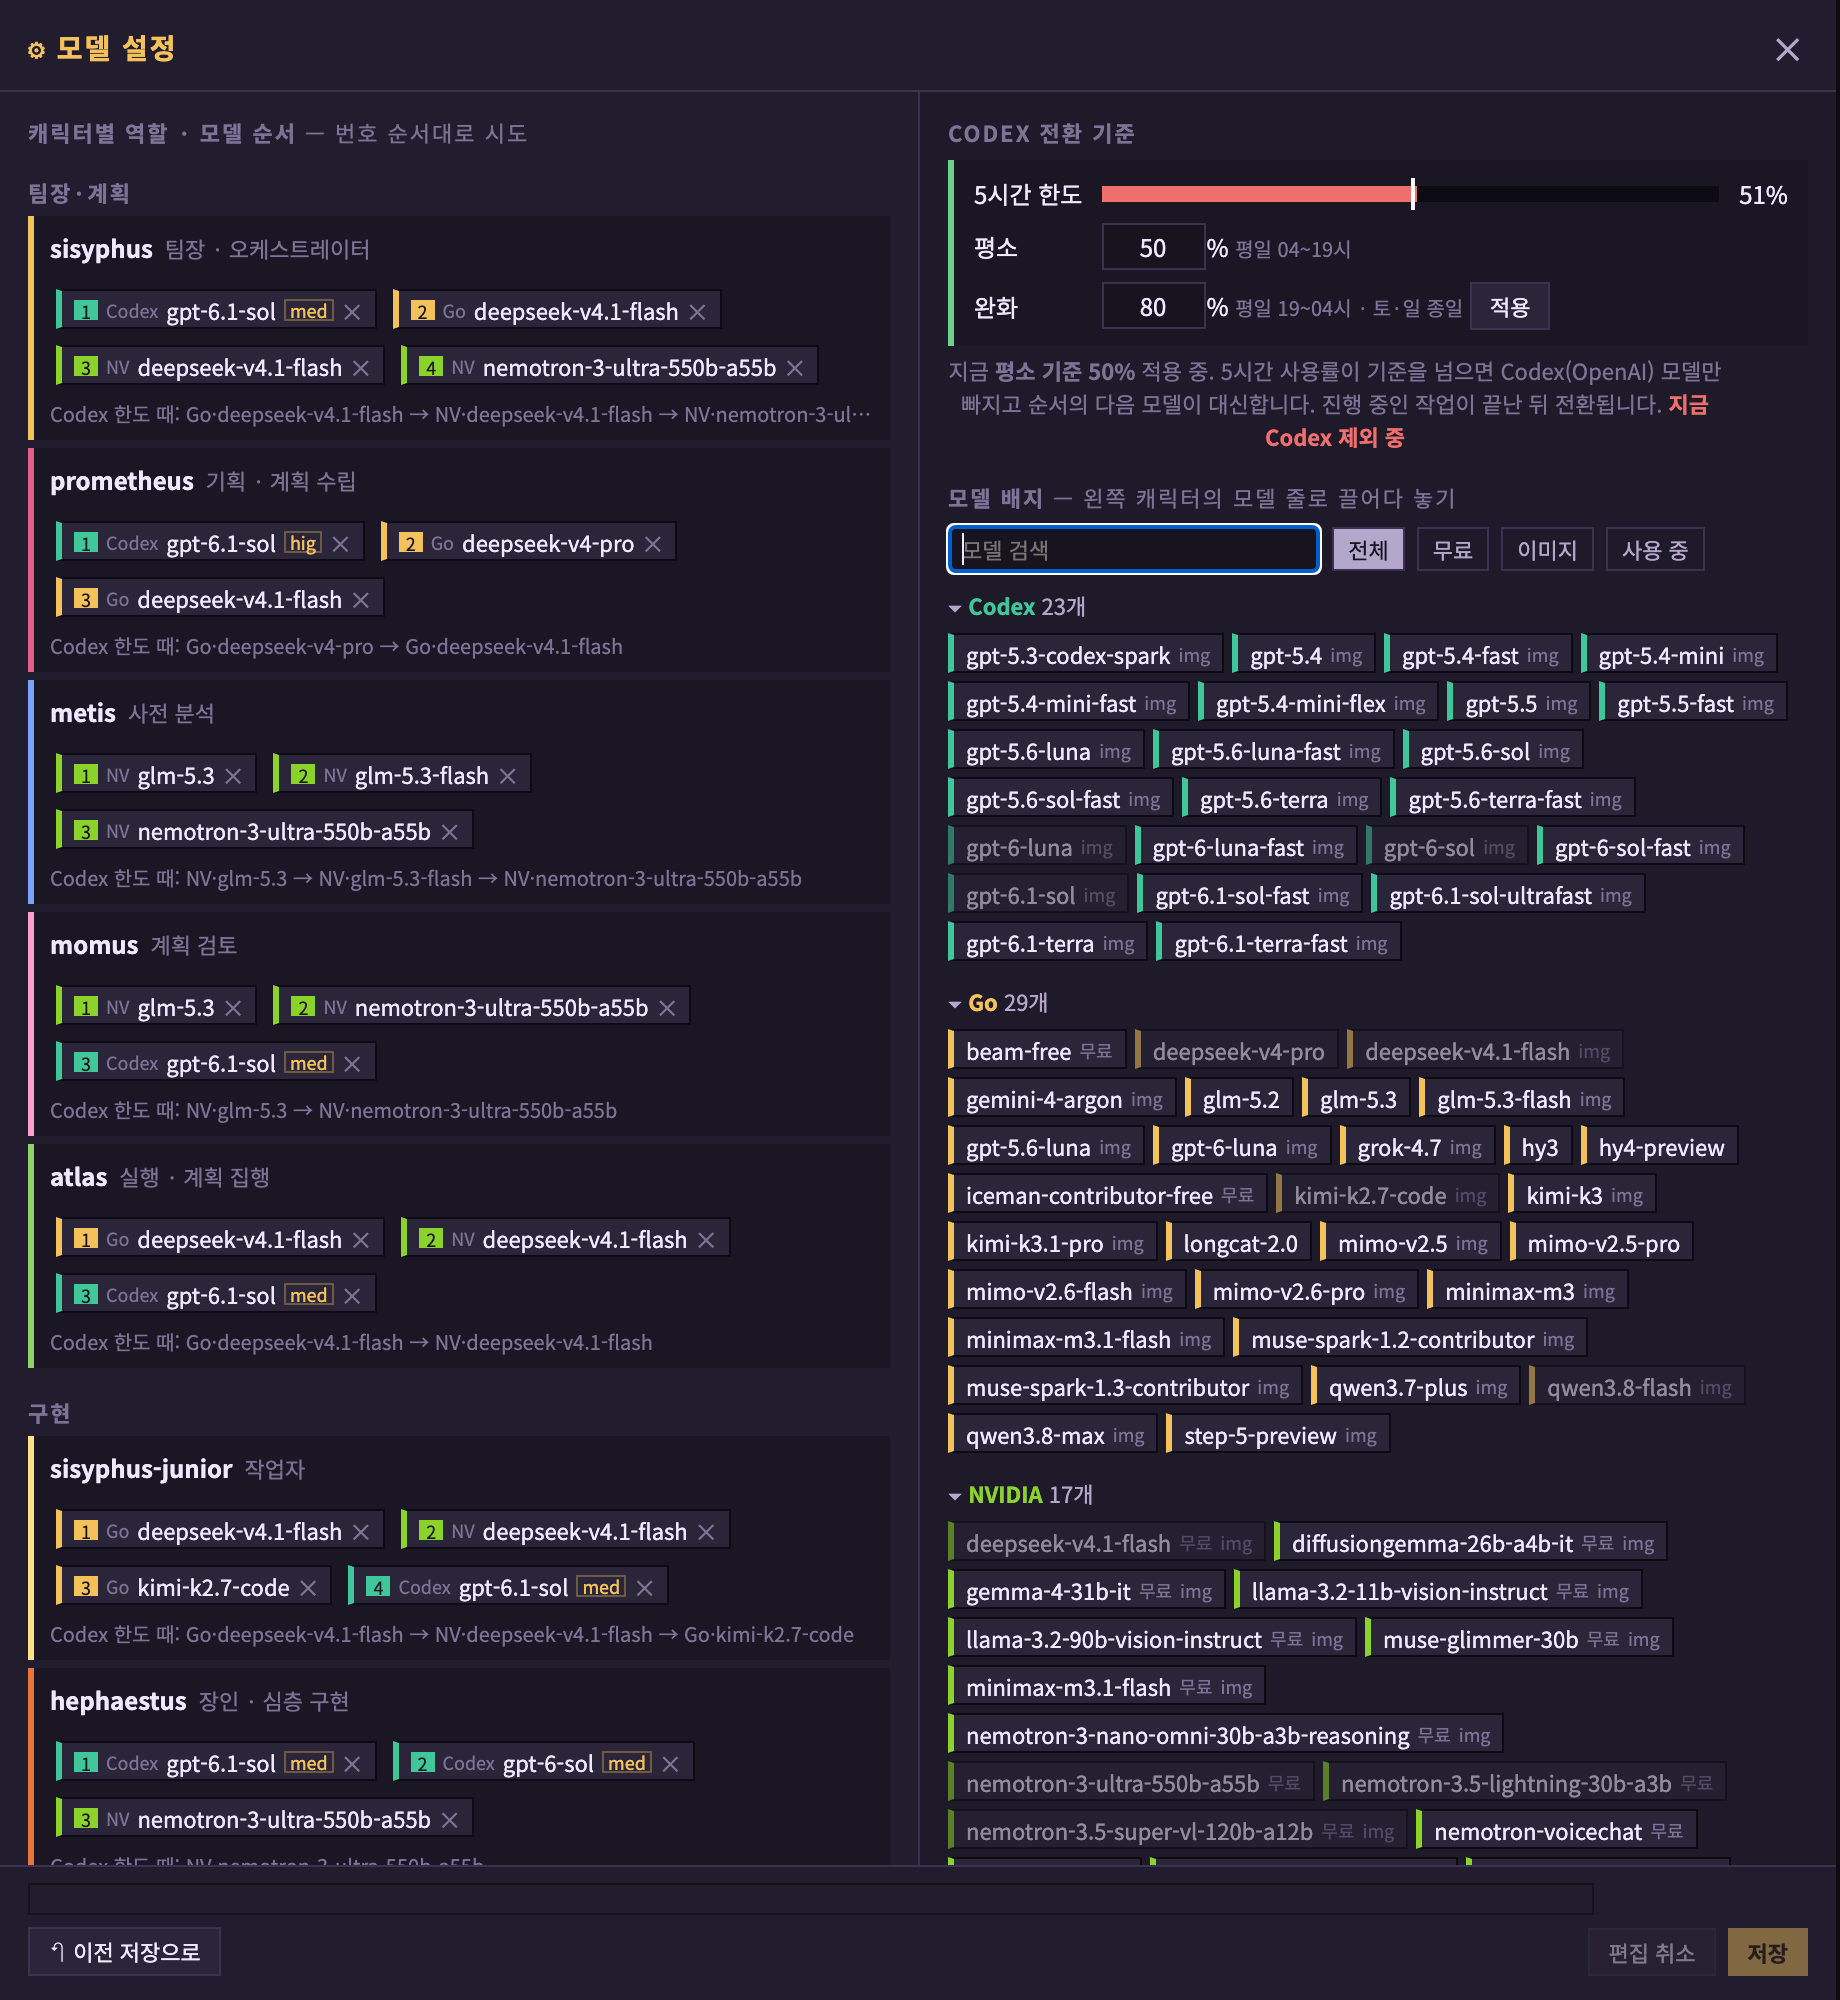
여러 번 갈아엎은 끝에 지금은 이렇게 돌린다. 원칙은 네 가지다.
- 지휘와 계획은 Codex가 맡는다.
- 구현은 Go DeepSeek가 맡는다.
- 검토는 구현과 다른 계열이 맡는다.
- 검색과 잡무는 무료 모델이 맡는다.
| 역할 | 1순위 → 대체 |
| sisyphus (팀장) | Codex gpt-6.1-sol → Go DeepSeek V4.1 Flash → NVIDIA DeepSeek V4.1 Flash(무료) → Nemotron Ultra |
| prometheus (계획) | Codex gpt-6.1-sol → Go DeepSeek V4 Pro → Go DeepSeek V4.1 Flash |
| sisyphus-junior · atlas (구현·집행) | Go DeepSeek V4.1 Flash → NVIDIA DeepSeek V4.1 Flash → … |
| oracle · pm (판단·기획) | Go DeepSeek V4 Pro → Codex → Go DeepSeek V4.1 Flash |
| metis · momus (분석·비판) | NVIDIA GLM-5.3 → … |
| explore · librarian (검색·조사) | NVIDIA Nemotron Lightning · Gemini Flash Lite |
| hephaestus (심층 구현) | Codex 전용 (OmO가 GPT 전용으로 설계한 역할) |
알게 된 것도 몇 가지 있다.
- NVIDIA에 DeepSeek V4.1 Flash가 무료로 있다. Go 한도가 찼을 때 유료 DeepSeek API보다 먼저 쓸 대체 모델로 딱이다.
- Go DeepSeek V4 Pro는 월 한도가 $15뿐이다. 판단 역할 여러 개의 1순위로 두면 금방 찬다.
- Codex 모델 중에도 쓰지 않는 게 있다. 무거운 상위 모델은 한도를 너무 빨리 먹어서 아예 금지 목록에 넣고, 같은 자리는 gpt-6.1-sol이 맡게 했다.
- 모델 이름이 비슷해도 provider마다 쓸 수 있는 모델 목록이 다르다. 그래서 설정 화면에서 "지금 OpenCode가 실제로 불러온 모델"만 고르게 했다. 이 설정 화면은 3편에서 다룬다.
3. 다른 provider의 사용량은 어떻게 보나
Codex는 사용량 조회 API가 있어서 정확히 볼 수 있다. 나머지는 사정이 제각각이다.
| provider | 볼 수 있는 것 | 방법 |
| OpenRouter | 무료 모델 하루 요청 수, 오늘 사용액 | 공식 API (/api/v1/key) |
| DeepSeek API | 계정 잔액 | 공식 API (/user/balance) |
| OpenCode Go | 모델별 5시간·주간·월간 사용률 | 공식 API가 없음 → 하네스 기록으로 추정 |
| NVIDIA | 오늘 요청 수, 분당 요청 수 | 크레딧 조회 API가 없음 → 하네스 기록 |
| Gemini | 오늘 요청 수·토큰 | 무료 등급 조회 API가 없음 → 하네스 기록 |
"하네스 기록"은 OpenCode가 응답마다 남기는 provider·모델·토큰·비용을 사무실 서버가 모아 둔 것이다. 요청 수와 토큰은 정확하다. 다만 Go 한도 비율은 서버가 집계하는 시각과 어긋날 수 있다. 그래서 화면에 [추정] 배지를 달았다.
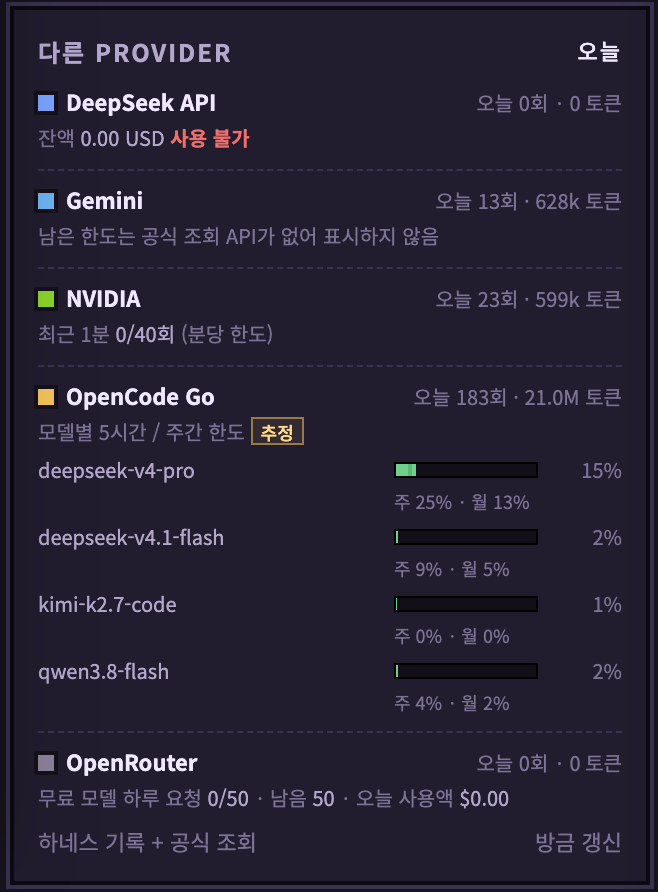
이 카드를 띄우자마자 DeepSeek API 잔액이 $0이라 대체 순서의 한 칸이 헛돌고 있다는 걸 발견했다. 사용량은 보여야 관리가 된다.
다음 편에서는 이 모든 걸 눈으로 보게 해 준 Agent Office와, 2주 동안 겪은 삽질 모음을 정리한다.
이전 글: (1) 설계와 작업 흐름
다음 글: (3) Agent Office와 삽질 모음
※ 이 글은 AI의 도움을 받아 작성했고, 작성자가 내용을 직접 검토한 뒤 올렸다.